Jevは、AIが書いた文章を見分けられるか、自分の記事で検証してみた
目次
話題の判定専用AI「Jev」に、AIが書いた自分の記事と、AIを使わずに書いた記事を1文ずつ判定させ、正解率とROC-AUCを実測しました。対照実験まで含めた検証の記録です。


このブログには、私が自分で書いた記事と、AI に書かせた記事の両方があります。
今回は、Jev に文章ごとに AI かどうかの判定、記事が AI かどうかの判定の2軸で精度を検証します。
Jev はテキストを返さない AI
Jev は TypeSafe AI が公開したモデルで、ChatGPT や Claude のように文章を生成しません。
公式ドキュメントによると、アプリの状態と型のついた質問を渡すと、型のついた判定だけを返す「System One モデル」という位置づけだそうです。
質問の型は 3 つあります。
| 型 | 返ってくるもの |
|---|---|
| noul | はいである確率(0〜1 の数値) |
| choice | 選択肢のうちどれか+各選択肢の確率+確信度 |
| score | 順序のある段階の評価値+確信度 |
料金は入力 100 万トークンあたり$0.042 で、出力トークンは無料とのことです。
今回使ったのは、はい・いいえを確率で返す noul です。
招待制から一般公開に切り替わった
もともと招待制のサービスでしたが、2026 年 9 月 21 日に一般公開されて使いやすくなりました。
手軽にトークンを発行できるようになったので、本家の API を直接叩く形で検証します。
判定させたのは、コードを除いた本文の 356 文
使った記事は 10 本です。
| ラベル | 記事 | 判定対象の文 |
|---|---|---|
| AI が書いた | laravel-upgrade-guide | 34 |
| AI が書いた | inertia-js | 55 |
| AI が書いた | iphone-external-ssd | 42 |
| AI が書いた | laravel-precognition | 45 |
| AI が書いた | laravel-boost | 55 |
| 私が書いた | vuejs-store | 11 |
| 私が書いた | laravel-relation-belongstomany | 30 |
| 私が書いた | laravel6-to-laravel8 | 12 |
| 私が書いた | laravel-breadcrumbs | 45 |
| 私が書いた | laravel-validation | 27 |
ここは正解ラベルの信頼性が全てなので、git の履歴で裏を取りました。
私が書いた 5 本は、最後に本文へ手を入れたのが 2025 年 5 月の自分のコミットで、その後はフッターの文言を一括削除しただけです。
AI が書いた 5 本は、2026 年に Laravel の新機能をキャッチアップしながら AI が書かせたものや、私が自分で作った Youtube 動画の内容を記事に書き出してもらったものを選択しています。
ただし、AI 側の 5 本はいずれも「私が実際に手を動かした内容を、文体のルールを与えたうえで AI に書かせた記事」です。
AI に丸投げして一般論を書かせた文章ではありません。
質問の作り方でつまずいた 2 か所
Jev に投げた質問はこんな感じです。
とは言っても、Claude Code (Ops)がすべてやってくれてるんですけどね。
QUESTION_SETS["a"] = {
    "written_by_ai": {
        "type": "noul",
        "instructions": "この日本語の文章は、人間が自分で書いたものではなく、生成AI(大規模言語モデル)が書いたものですか?",
        "criteria": {
            "true": "生成AIが書いた文章に見える。説明が整いすぎている、主語や接続がテンプレート的、体験の具体性が乏しい、語彙や語尾が均質、など。",
            "false": "人間が自分で書いた文章に見える。話し言葉の混入、脱線、誤字や言い回しの癖、個人的な感想や感情、不揃いな文の長さ、など。",
        },
    },
    "ai_likeness": {
        "type": "score",
        "instructions": "この日本語の文章の「生成AIが書いたらしさ」を評価してください。",
        "criteria": [
            "明らかに人間の手書き。口語や言い回しの癖が強く、AIはこう書かない。",
            "おそらく人間。個人的な体験や感情がそのまま出ている。",
            "どちらとも言えない。事実の記述だけで書き手の癖が出ていない。",
            "おそらく生成AI。説明が整っており、文の構造が均質。",
            "明らかに生成AI。教科書的で、定型表現と網羅的な言い換えが目立つ。",
        ],
    },
}
1 文ずつの正解率 46.1%
356 文を投げた結果です。
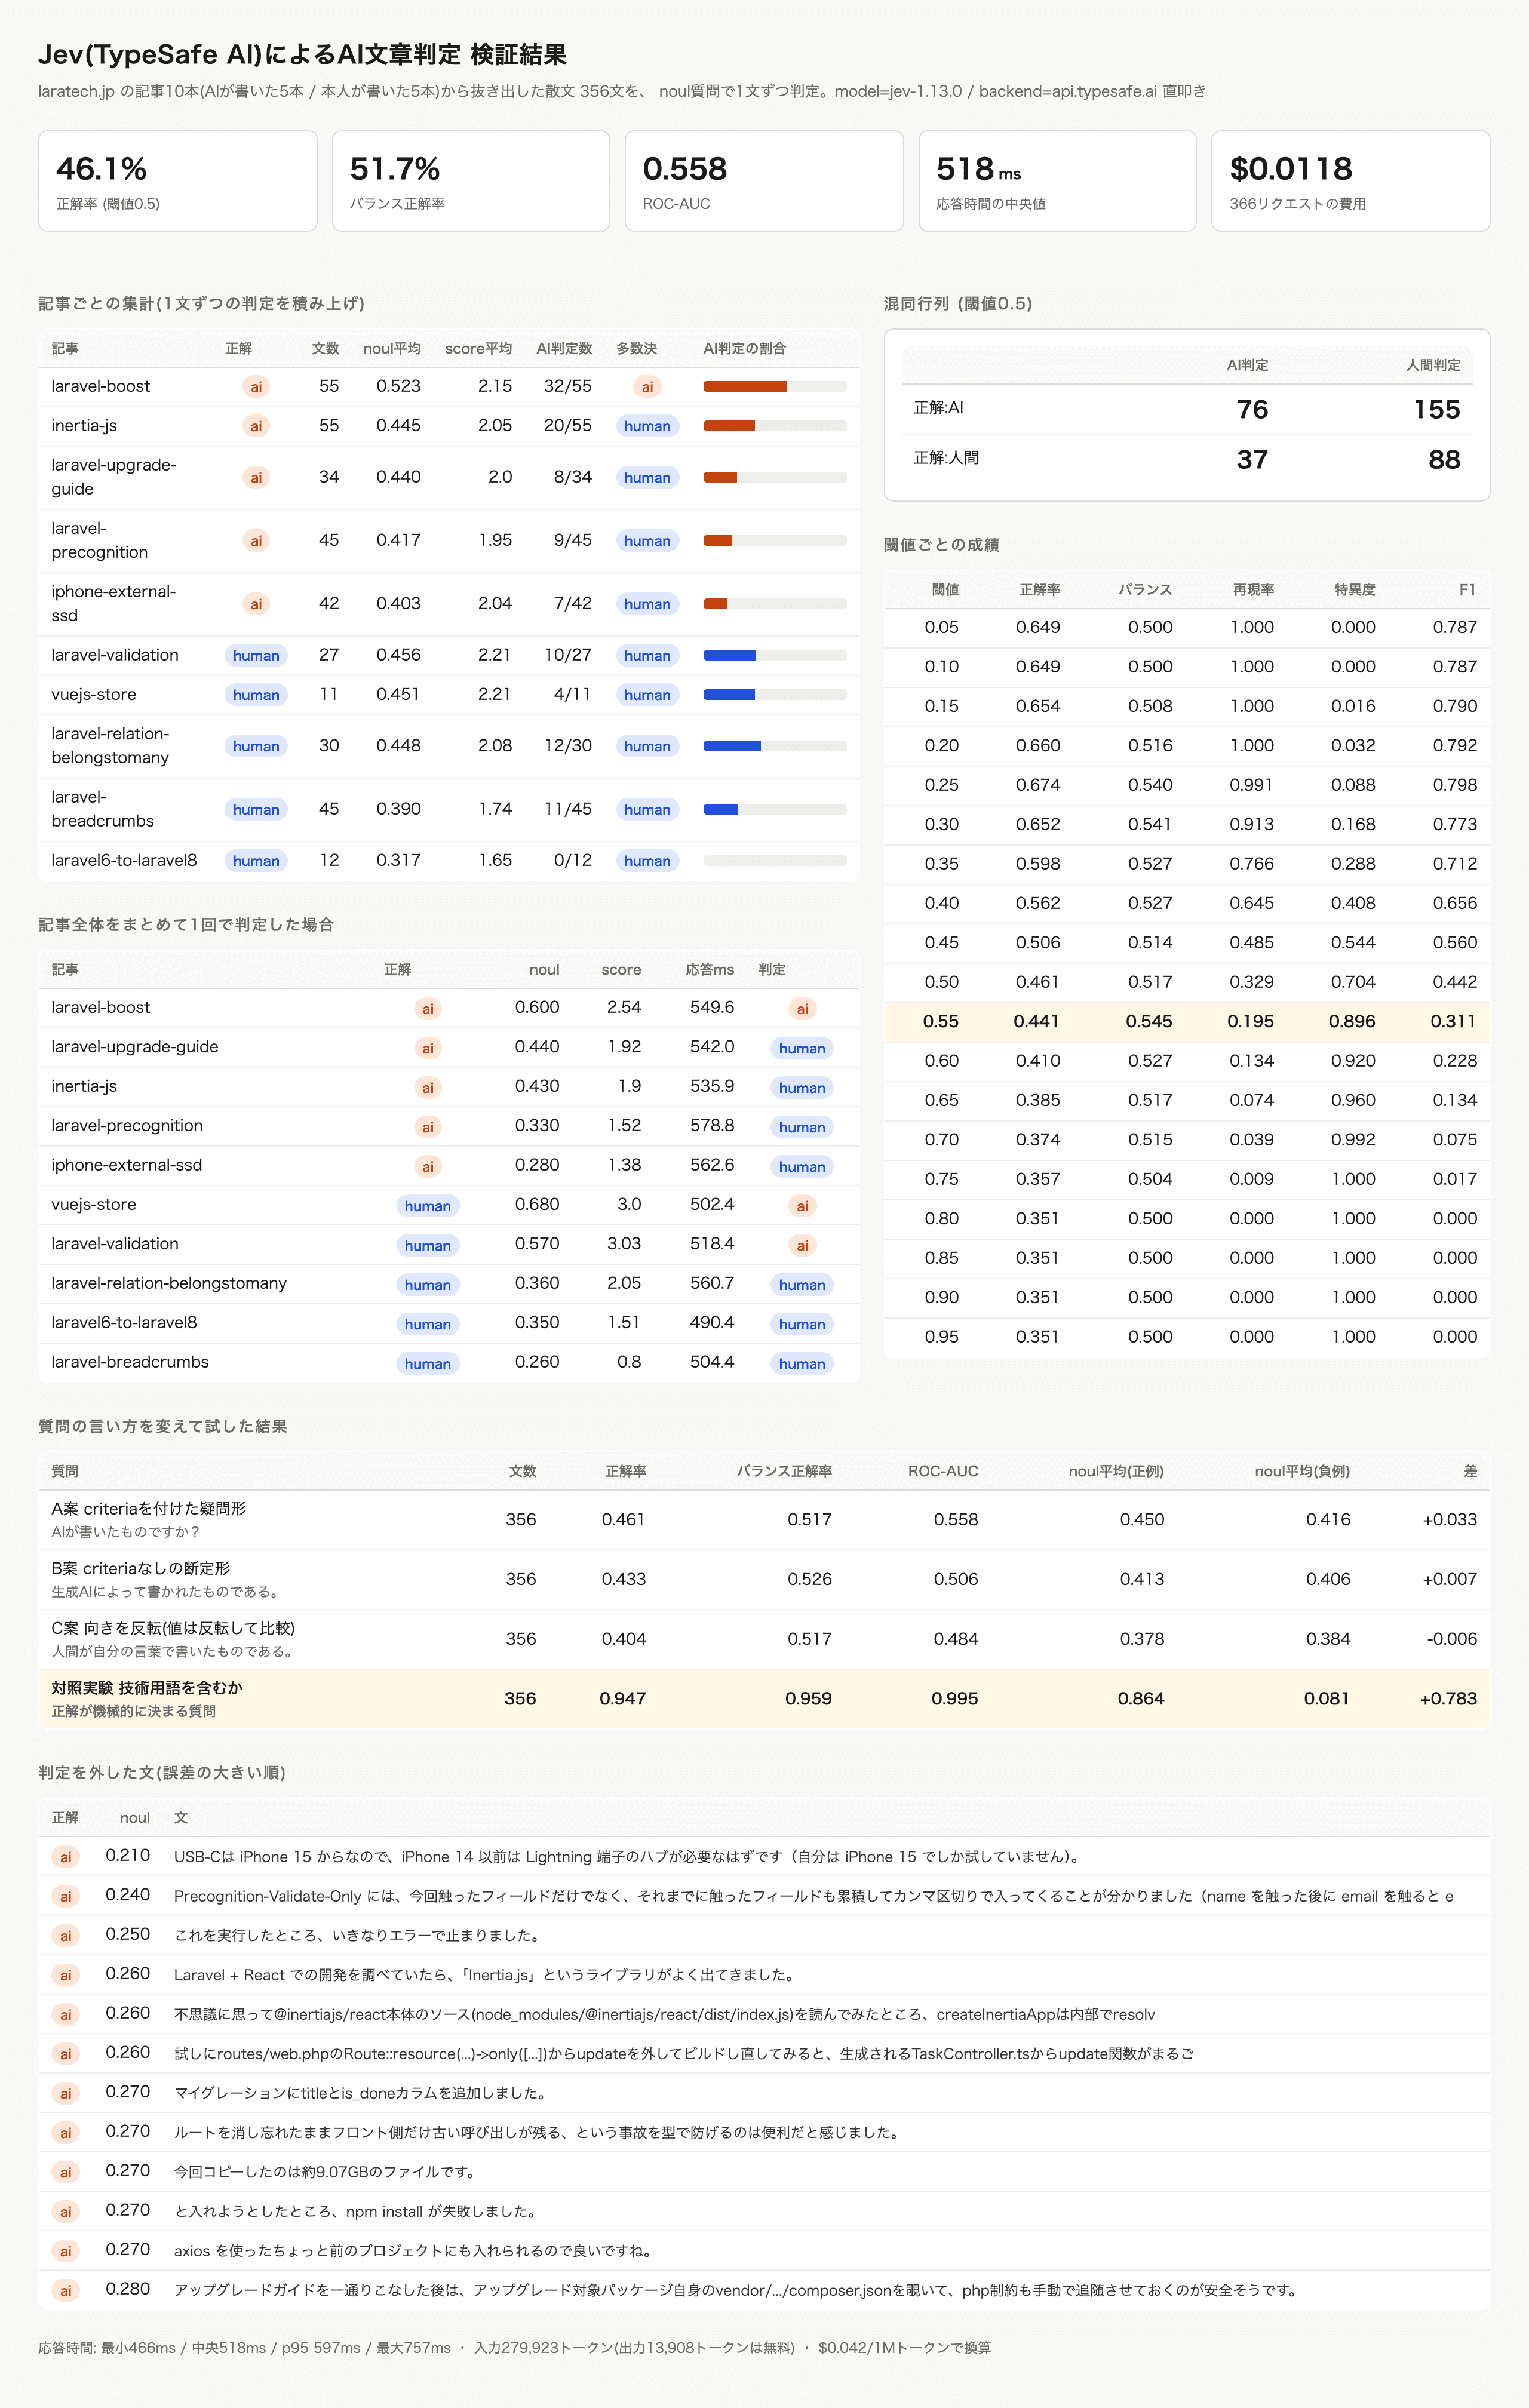
閾値 0.5 での正解率は 46.1%でした。
件数の偏りを除いたバランス正解率が 51.7%、ROC-AUC は 0.558 です。
ROC-AUC は 0.5 で「まったく区別できていない」、1.0 で「完全に区別できる」という指標なので、0.558 はほぼ区別できていないということになります。
混同行列はこうなりました。
| AI と判定 | 人間と判定 | |
|---|---|---|
| 正解:AI | 76 | 155 |
| 正解:人間 | 37 | 88 |
AI が書いた 231 文のうち、AI と判定できたのは 76 文だけです。
全体としては「人間が書いた」側に寄せる傾向が出ていて、閾値を 0.55 まで動かしてもバランス正解率は 54.5%までしか上がりませんでした。
noul 値の分布を見ると、そもそも両者が重なっていることが分かります。
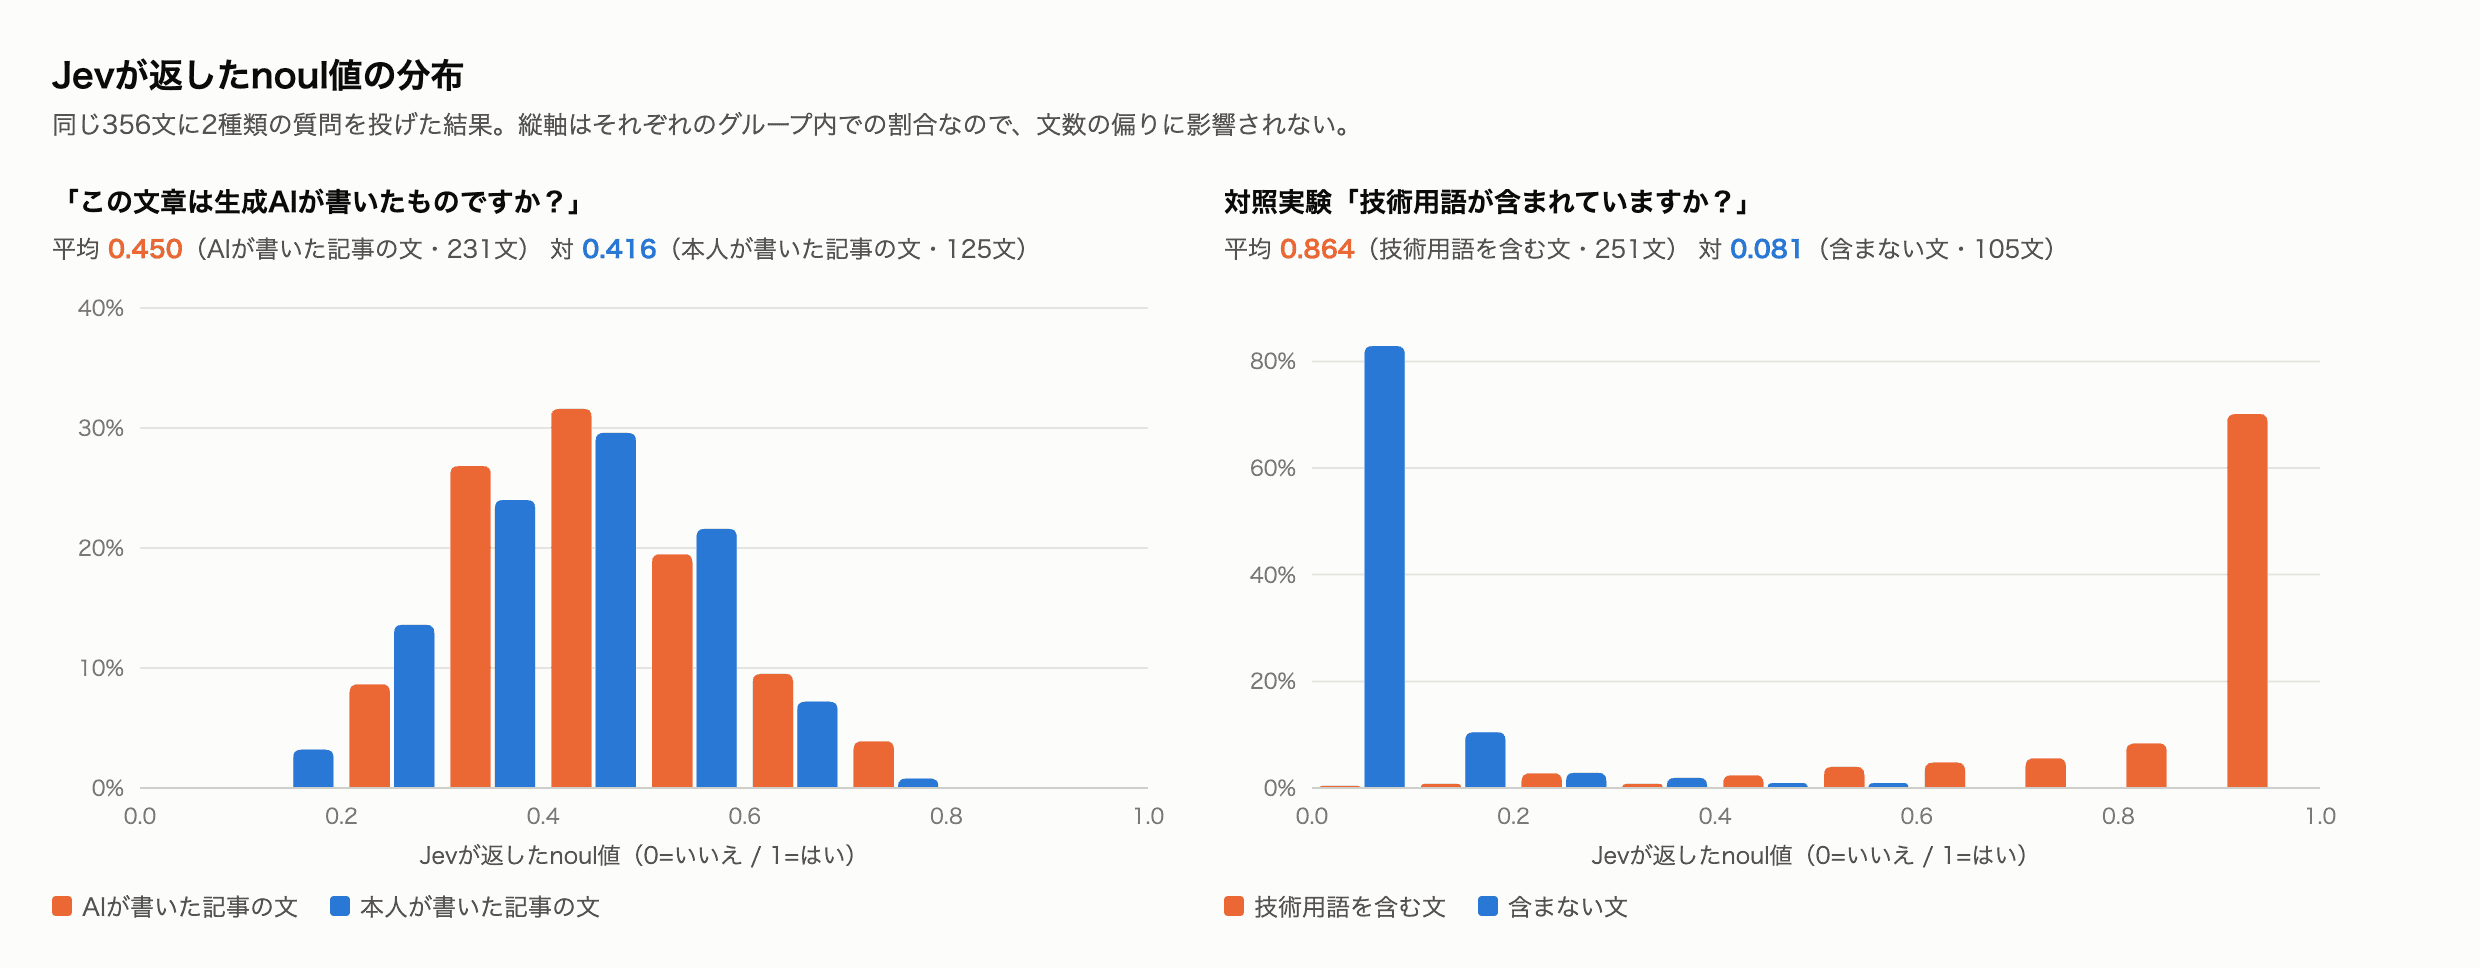
AI 側の平均が 0.450、私側の平均が 0.416 で、その差はわずか 0.033 でした。
記事単位でまとめても 6 勝 4 敗
1 文ずつでは無理でも、記事ごとに多数決を取れば当たるのではないかと考えました。
結果は 10 本中 6 本正解です。
私が書いた 5 本は全部正解でしたが、これは「全体的に人間寄りに答える」傾向の副産物なので、当たったというより外れなかっただけです。
AI が書いた 5 本のうち、AI と判定できたのは laravel-boost の 1 本だけでした。
記事全体を 1 回のリクエストでまとめて判定させた場合は、さらに悪くなって 4 本正解です。
このとき最も「AI が書いた」と判定されたのは、私が 2019 年に手書きした vuejs-store(noul 0.680)でした。
自分の書いた記事が AI 判定でトップに来るのは、なかなか複雑な気分です( ̄ ▽  ̄;)
質問の言い方を 3 通り試しても変わらなかった
公式ドキュメントに、質問は疑問形と断定形の両方を自分のデータで試すようにという記述があります。
自分の質問文が悪かっただけかもしれないので、言い方を変えて全文流し直しました。
| 質問 | 正解率 | バランス正解率 | ROC-AUC |
|---|---|---|---|
| criteria を付けた疑問形 | 0.461 | 0.517 | 0.558 |
| criteria なしの断定形 | 0.433 | 0.526 | 0.506 |
| 向きを反転(人間が書いたか) | 0.404 | 0.517 | 0.484 |
criteria で判断基準を細かく書いた版が一番マシで、それでも AUC 0.558 です。
説明を省いた断定形は 0.506、聞く向きを反転させた版は 0.484 で、偶然を下回りました。
質問の書き方の問題ではなさそうです。
「AI が書いたか」と「人間が書いたか」は裏返しにならない
反転版は、そのまま面白い結果になりました。
「AI が書いたか」の確率と、「人間が書いたか」の確率を 1 から引いた値は、同じ文に対して一致するはずです。
ところが 0.5 を境にした判定が一致したのは 356 文中 264 文、74.2%しかありませんでした。
差の平均は 0.058、最大では 0.44 も離れています。
これは公式ドキュメントが既知の癖として挙げている内容そのもので、P(noul) と 1 - P(not noul) は直接比較できないと明記されています。
人間と AI 以外が記事を書いた可能性は捨てきれないですからね。
同じ 356 文に、答えの決まっている質問を投げた
ここまでで「Jev では見分けられなかった」と書けますが、それだけでは Jev 自体が使えないのか、この質問が答えられないものなのかが区別できません。
そこで、まったく同じ 356 文に対して、正解を機械的に決められる質問を投げました。
「アルファベットや数字で書かれた技術用語が含まれていますか?」という質問にして、正解は「3 文字以上の英数字の連なりが文中にあるか」で機械的に付けています。
結果は正解率 94.7%、バランス正解率 95.9%、ROC-AUC は 0.995 でした!
noul 値の平均は、含む文が 0.864、含まない文が 0.081 です。
先ほどの分布図の右側がこの結果で、同じ文なのにきれいに分かれています。
つまり Jev は正常に動いていて、今回の 356 文にも十分な情報が入っていました。
「この文章の書き手が AI かどうか」という質問だけが、答えの根拠を文面から取れなかったということです。
外した 18 件も見てみると、URL や API、iPhone、foreach を含む文を「技術用語を含まない」と答えていました。
私が criteria に「製品名・コマンド名・パッケージ名・ファイル名など」と書いたので、そこに当てはまらないと判断したようです。
これも公式ドキュメントが最初に挙げている癖(書いた質問どおりに文字通り読む)と一致していました。
質問文を詰めるほど、詰めた範囲の外は切り捨てられるということですね。
1,434 リクエストで$0.03、応答は 500ms 台だった
今回の検証で実際にかかったコストと応答時間を表にまとめました。
| 項目 | 実測値 |
|---|---|
| リクエスト数 | 1,434 |
| 入力トークン | 684,893 |
| 出力トークン | 37,404(無料) |
| 費用 | $0.0288 |
| 応答時間の中央値 | 515ms |
| 応答時間の最小・最大 | 464ms・1,027ms |
356 文を 6 並列で流して 31 秒でした。
早いですね〜。
Jev は 70〜500ms で返ると紹介されていますが、日本語の文に対して 2 問同時に投げた今回の条件では、中央値 515ms でその上限付近でした。
費用は全部合わせて、たったの 3 セントです!(日本円で4〜5円?)
判定を 1 文ずつ 1,434 回試して 3 セントなら、精度が出る用途では相当使いやすい価格だと感じました。
ちなみに、無料枠です。
なお、noul と score を同時に投げた A 案は 356 文で入力 256,386 トークン、質問 1 つだけの B 案は 124,310 トークンでした。
質問文も入力トークンに乗るので、criteria を丁寧に書くとその分だけ費用が増えます。
何が向いていて、何が向いていないのか
今回の結果から、Jev が得意な質問とそうでない質問の線引きが、はっきり分かりました。
判定の根拠が文の中に書かれている質問には、95%を超える精度で答える
ということです。
つまり、判定の根拠を人間が定義することができるものに対してはかなりの威力を発揮し、精度・コスパ・応答速度など満足の得られる結果になるのだと分かりました。
「この文章の書き手が人間か AI か」は、判定の根拠を私が用意していないが故に精度が悪かったのだと思います。
書いてある内容ではなく、書いた人の正体を当てる質問だからです。
今回の検証で個人的に一番良かったのは、AI で書いた 5 本が判別されなかったことです。
頑張ってプロンプトを書いてますからね。
ハハハ!出し抜いたぜ!!
まとめ
Jev を使う時は、判定の根拠をこちらで定義する。
応答速度は速い。
一問一答形式の機能では特に速度を感じることができると思います。
1 件 0.0032 円(0.00002 ドル)で答えてくれる安価なモデル。安い!(10,000 件で 32 円)
Jev は応答速度に関して感動する投稿が目立ち、精度の部分で疑問視する声が多数あったと思います。
特に、トレーダーの自動売買の機能では「損をした」ような自虐の投稿が多かったような気がします。
それは判定を自分で定義せず Jev 側に根拠を渡していないことが原因なのだと思います。
自分でやっていることを雰囲気で伝えるのではなく、正確な言語化ができれば有用な AI なのだと思います。
自分もこれから実務・人生のなにかで使い道がないか研究していきたいと思います。


